AI FinOps es un problema de arquitectura
Tu factura de LLM llega como un simple número. Un monto agregado por cuenta, al final del mes, sin identificar qué equipo gastó, qué aplicación disparó el consumo o qué agente de IA entró en un bucle después del despliegue del viernes. Sabes cuánto costó, pero no sabes a quién le corresponde la cuenta.
En la disciplina de FinOps de los proveedores de nube, este problema se resolvió hace tiempo con el uso de etiquetas, donde cada recurso de cómputo lleva una etiqueta de centro de costos, y la distribución de costos se obtiene de forma natural a través del propio proveedor. En GenAI esto no funciona, por un motivo estructural: no existe un recurso que etiquetar. Existe una llamada HTTP efímera, que nace y muere en segundos, consume una cantidad de tokens que nadie previó y no deja ningún objeto persistente detrás.
La unidad de costo de AI FinOps no es el recurso: es la solicitud. Y el único lugar por donde pasa cada solicitud de principio a fin, con la información del modelo elegido, el conteo de tokens, la identidad de quien hizo la llamada y la latencia de respuesta, es tu AI Gateway.
Este artículo muestra, de forma práctica, cómo Sensedia AI Gateway (como capa central de gobernanza de IA) puede transformar esto en una disciplina financiera completa al medir, establecer precios, atribuir y gobernar tu gasto en IA.
Cuatro capas de AI FinOps
Antes de hablar de métricas y dashboards visuales, conviene establecer el modelo mental. AI FinOps se sostiene sobre cuatro capas, y el orden entre ellas no es una elección arbitraria.
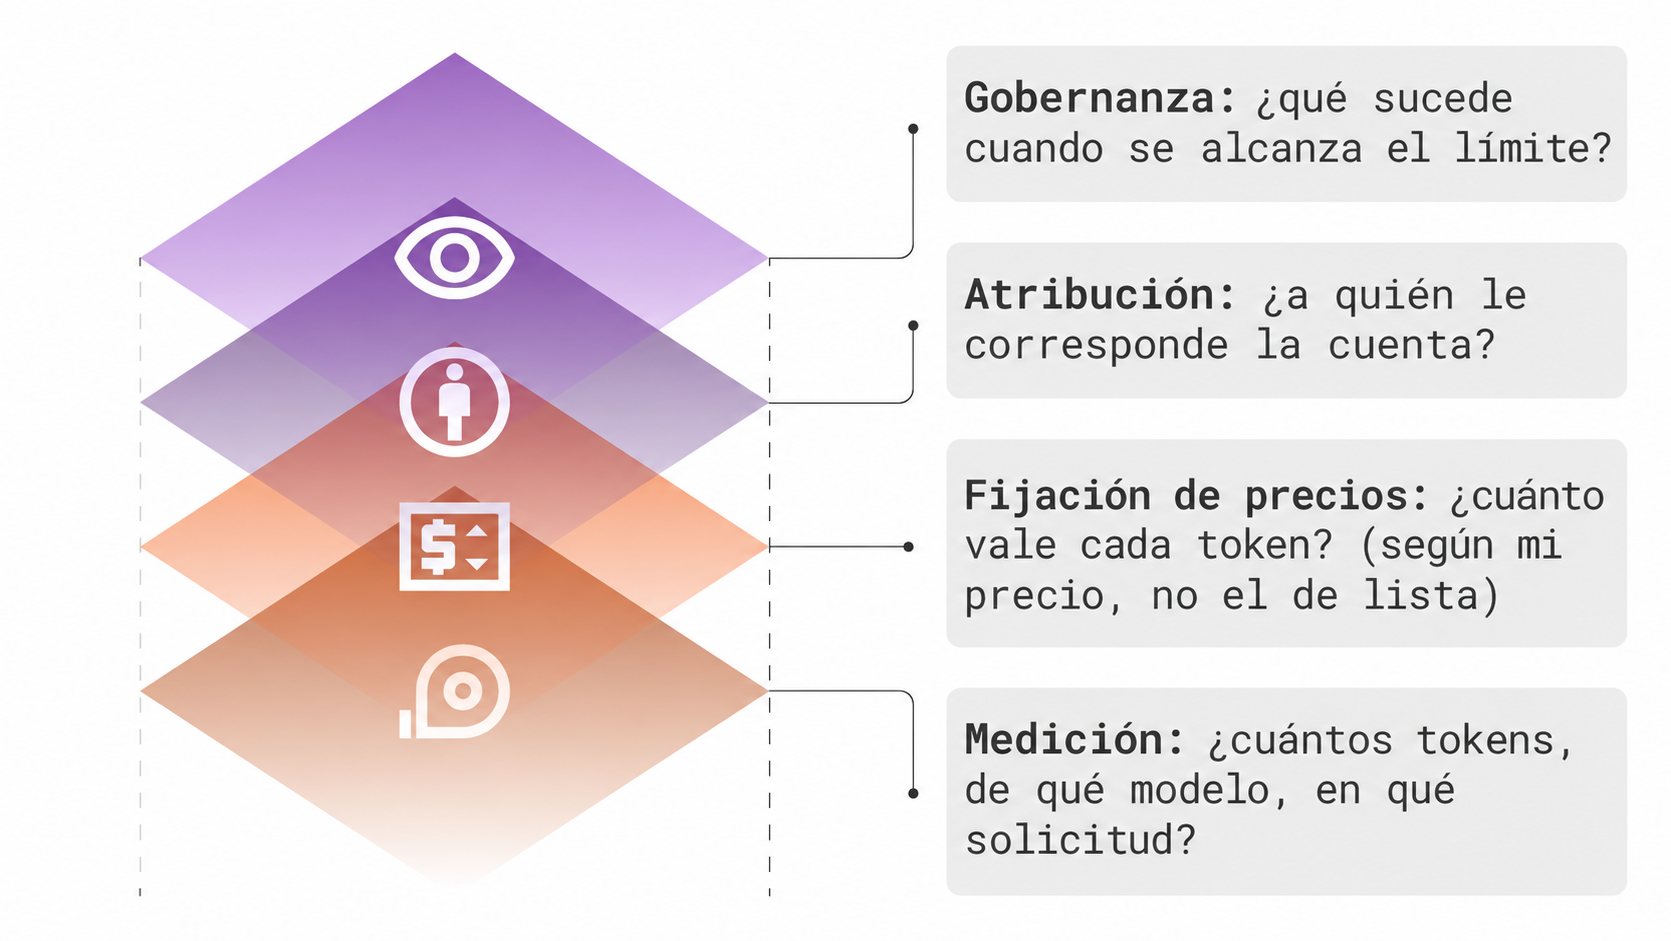
Cada capa solo existe si existe la anterior. El chargeback sin tu precio negociado debidamente configurado es una ficción contable: distribuyes entre los equipos un costo que no es el que paga tu empresa. Un budget sin costos en tiempo real se convierte en una simple alerta post mortem: solo descubres que se excedió el presupuesto después de que ocurrió. Las iniciativas de FinOps que empiezan por la capa superior, con un reporte atractivo de distribución de costos sobre una base que no existe, tienden a estancarse con mayor facilidad. Sensedia prefirió construir esto de abajo hacia arriba.
Capa 1 de AI FinOps: Medición
El costo debe originarse en el data plane
La primera decisión de arquitectura de Sensedia AI Gateway también es la más determinante: el costo se calcula en el data plane, con cada solicitud. No existe una tarea programada que lea la factura del proveedor, ni una conciliación por lotes contra un CSV de facturación.
Cuando una solicitud de LLM atraviesa nuestro Gateway, el data plane identifica el par proveedor + modelo, consulta el catálogo de precios vigente para ese par (considerando posibles precios personalizados registrados por el propio cliente) y emite el costo en moneda (USD) junto con la propia telemetría de la solicitud. El costo se convierte en un atributo de la solicitud, disponible en el mismo instante en que esta termina y se convierte en telemetría.
Esto parece un simple detalle de implementación, pero no lo es. Es precisamente lo que hace posibles las capas 3 y 4: no puedes impedir que se exceda un presupuesto con un dato que solo llega al cierre del mes. Un rate limit basado en costos en tiempo real, obviamente, exige costos en tiempo real. Y el costo en tiempo real exige que el cálculo se haga en el recorrido de la solicitud.
Qué contiene la telemetría
El costo se emite como una métrica acumulada y como un atributo del trace de la llamada, siempre acompañado de las dimensiones que permiten desglosarlo para futuros reportes. Por ejemplo:
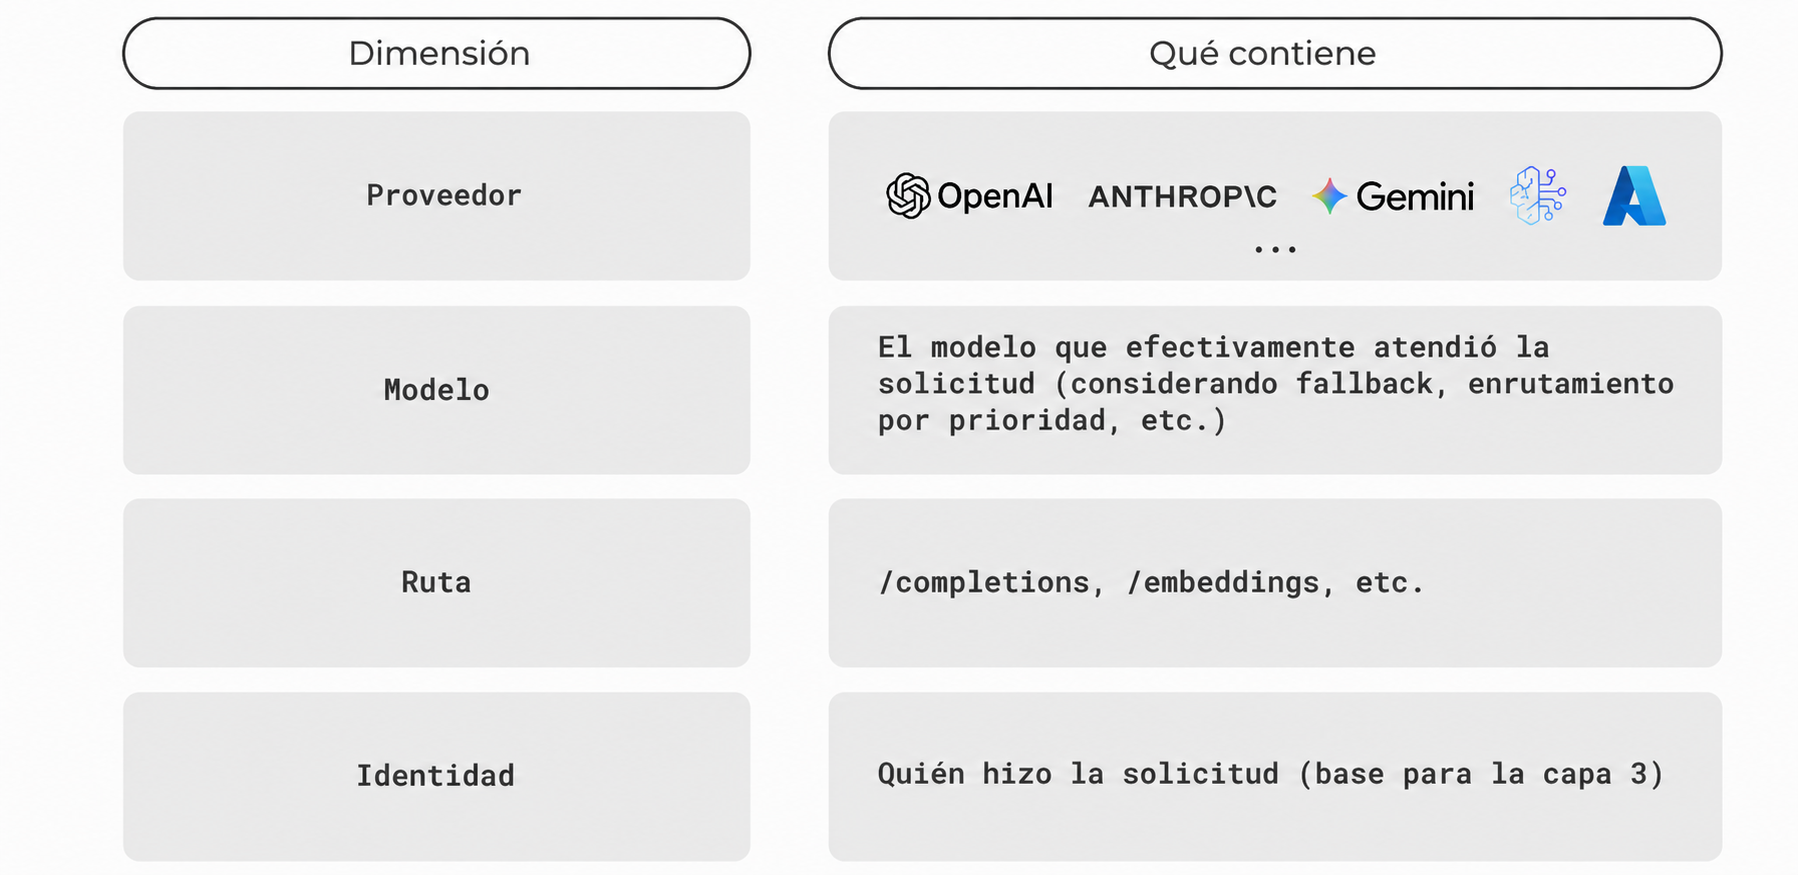
Y el consumo de tokens no es solamente un número. Se separa en cuatro tipos: entrada, salida, lectura de caché y escritura de caché, porque cada uno tiene precios diferentes. Esta separación es importante, ya que es la que transforma la caché de una simple métrica de rendimiento en una métrica financiera, como veremos en el showback.
Capa 2 de AI FinOps: Fijación de precios
El precio de lista no es tu precio
La mayor parte de las herramientas del mercado calcula el costo con el precio público del proveedor de LLM. Funciona como estimación, pero no como base para la distribución interna de costos. Las grandes empresas no pagan precios de lista. Generalmente existen descuentos por volumen, contratos empresariales o condiciones especiales negociadas por modelo. Las empresas que optan por modelos open-weight en infraestructura propia también necesitan una forma personalizada de configurar ese precio.
Si el monto que distribuyes entre tus equipos no es el que paga tu empresa, el chargeback pierde legitimidad ante el primer cuestionamiento. Sensedia AI Gateway resuelve esto con un catálogo de precios en capas.
Base pública con sobrescritura del cliente
La capa base proviene de una fuente pública de precios de mercado, actualizada mediante un ciclo de actualización. Sobre esa base, puedes definir tus propias tarifas, y la sobrescritura es aditiva: sobrescribes el precio de GPT-4o sin modificar los otros cientos de modelos del catálogo público. Cada precio de la lista muestra su origen según las capas existentes:
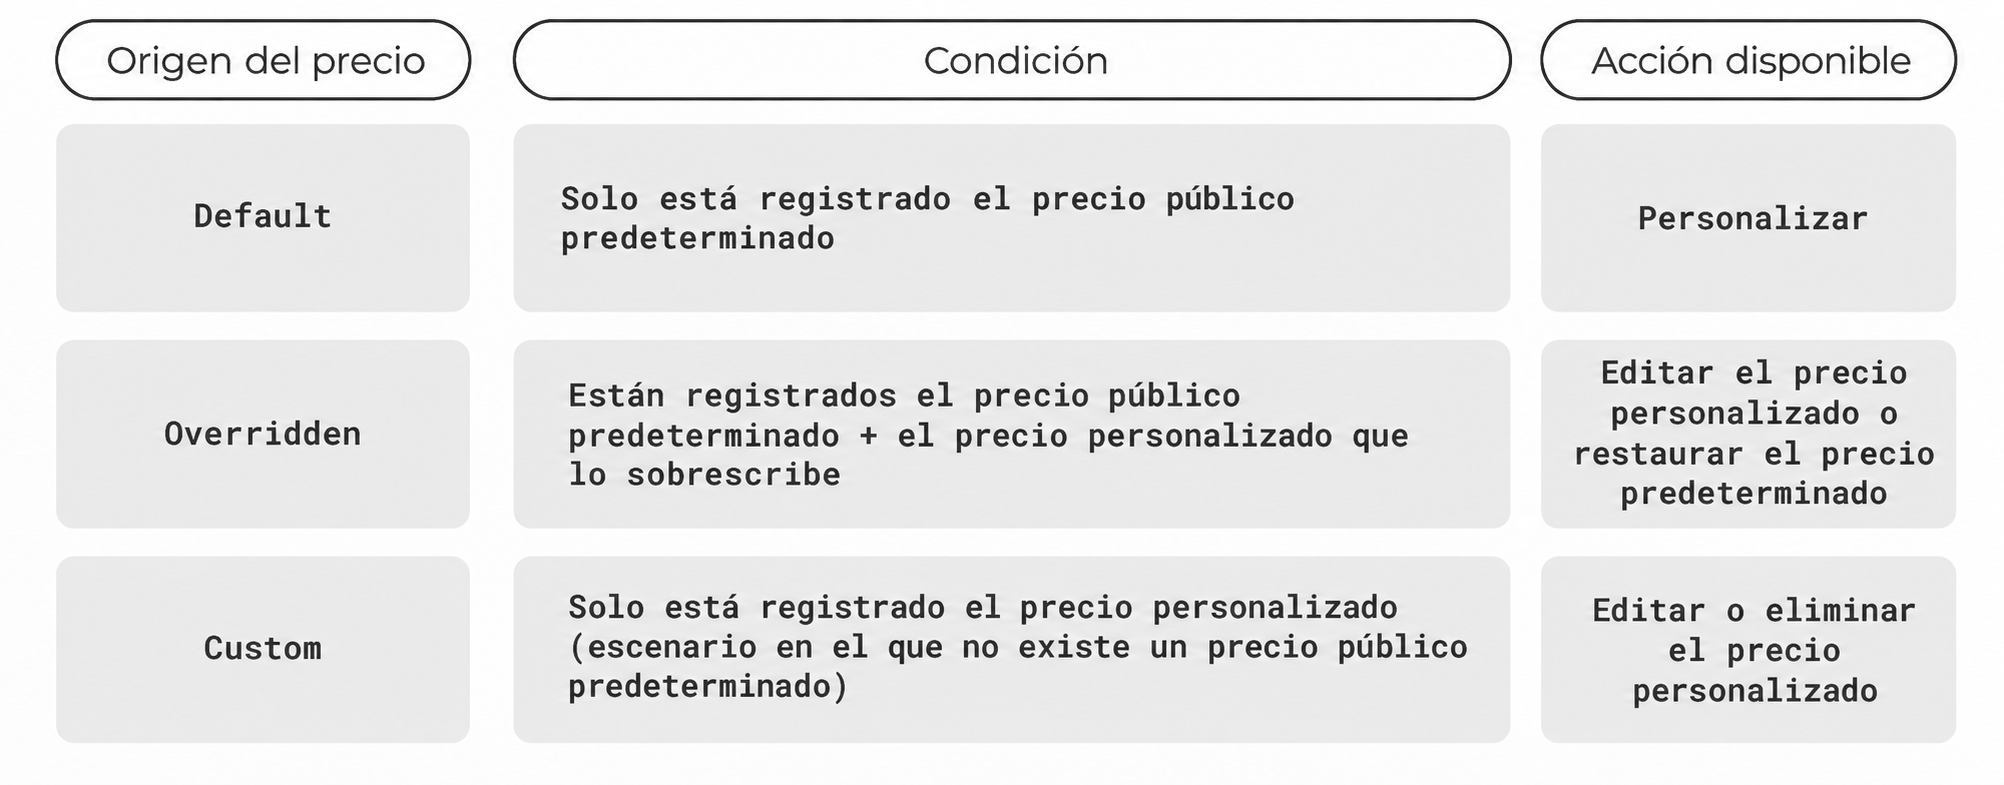
El término es Overridden, no Replaced, y esa elección refleja el comportamiento: el precio predeterminado se conserva, no se elimina. Al abrir el detalle de un precio sobrescrito, tu tarifa y la del mercado aparecen una al lado de la otra (lo que ya es, por sí mismo, un dato para negociar). Y, al eliminar un precio Overridden, el sistema vuelve al precio predeterminado en lugar de dejar al modelo huérfano.
Dos decisiones que importan
Existen dos comportamientos que suelen pasar desapercibidos y que son importantes para quienes operan en un sector regulado:
- La modificación de precios no es retroactiva. Cambiar, restaurar o eliminar un precio aplica al consumo futuro. El costo histórico ya calculado no se recalcula, porque es un hecho histórico, registrado bajo la tabla de precios vigente en ese momento. Si fuera una vista recalculable, el reporte de un mes cambiaría al mes siguiente, lo que dificultaría cualquier cierre contable.
- Un modelo sin precio activo no emite telemetría con costo cero. Si un modelo no tiene un precio definido en el catálogo, su consumo se contabiliza normalmente en tokens y se excluye del costo en moneda. Esto ocurre porque, a nuestro entender, un costo no calculado es distinto de un costo cero. Un sistema que silenciosamente suma cero al total produce un reporte que cuadra y parece correcto, pero que está esencialmente equivocado.
Qué producen las dos primeras capas
Showback
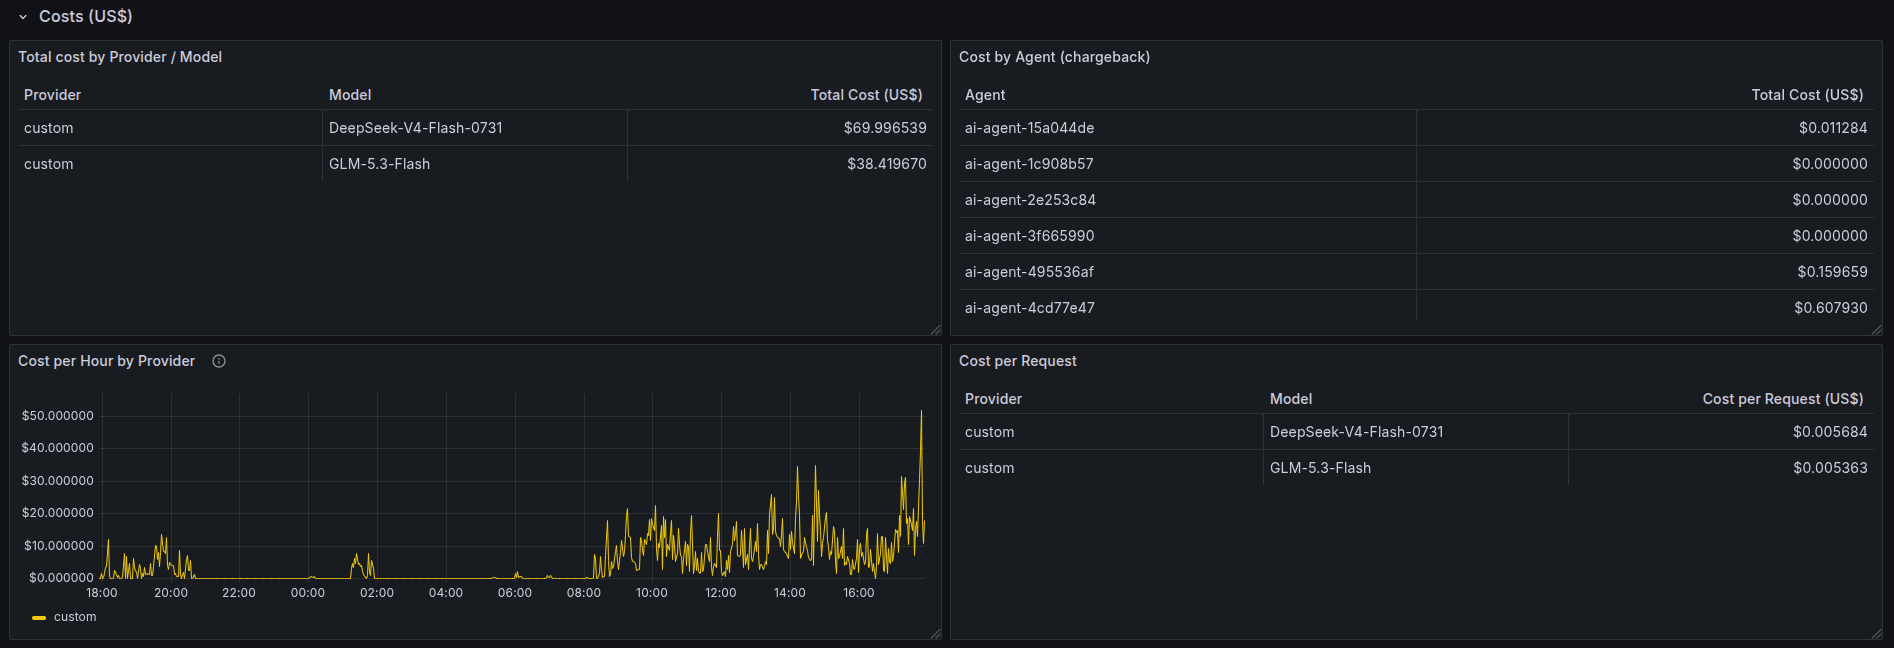
Con el costo medido y valorado correctamente, y con las dimensiones correspondientes implementadas en las vistas, el showback es una simple consecuencia. Los dashboards de costos de Sensedia AI Gateway desglosan el costo por proveedor, modelo y agente de IA, con evolución temporal y una vista de los mayores consumidores. Lo que distingue al showback de una simple “gráfica de consumo” son los siguientes detalles.
Economía unitaria
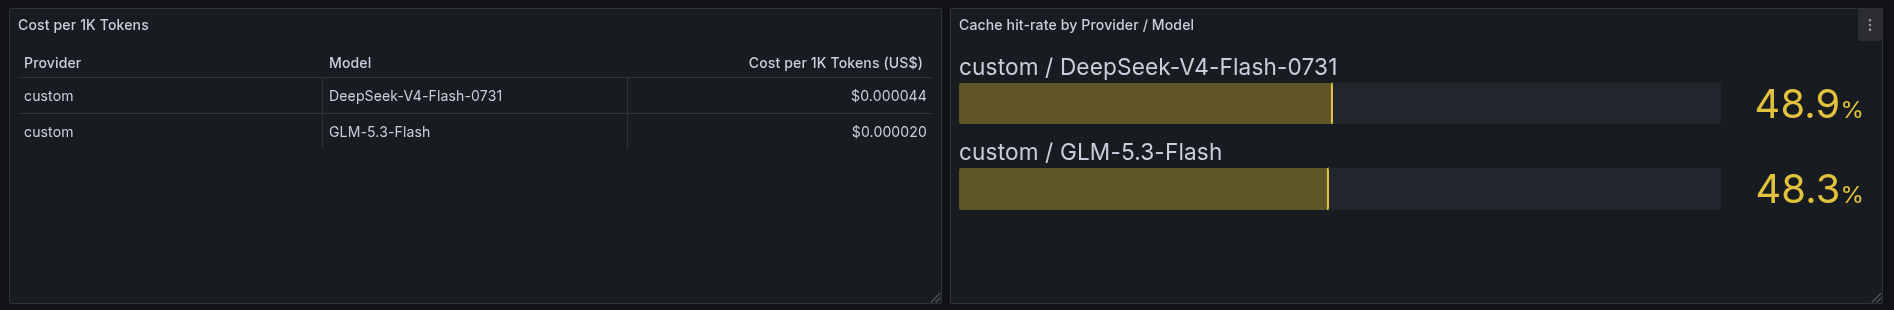
Dos indicadores cambian la conversación: costo por solicitud y costo por 1,000 tokens. Responden a la pregunta que la gráfica de costo total no responde: ¿mi agente se volvió más caro o simplemente se usa más?
Son preguntas con respuestas opuestas. Un crecimiento del costo total que mantiene estable el costo por solicitud es una señal de adopción, y es una buena noticia que probablemente merece más presupuesto. En cambio, el aumento del costo por solicitud con un volumen estable es una señal de posible deterioro: un prompt que se vuelve más extenso, un contexto que crece en cada iteración, un reintento silencioso o alguien que cambió el modelo sin avisar.
Sin un análisis de costos unitarios, ambos casos aparecen en el dashboard como la misma línea ascendente. Los dos indicadores se obtienen al cruzar las series que emite la capa 1: el costo del periodo dividido entre el número de solicitudes, y el costo del periodo dividido entre el total de tokens en miles. Ninguno exige instrumentar la aplicación, porque el AI Gateway ya tiene ambas partes.
Tasa de aciertos de caché como métrica financiera
Volvamos a la separación de los cuatro tipos de tokens de la capa 1. Como la lectura de caché tiene un precio independiente, equivalente a una fracción del precio de la entrada normal, la tasa de aciertos de caché deja de ser un indicador de rendimiento y se convierte en una palanca directa para reducir costos.
El cálculo es la proporción entre los tokens leídos de la caché y el total de tokens de entrada. Cuanto mayor sea ese número, menor será el costo por solicitud, sin requerir ningún cambio de modelo. Un equipo que reestructura sus prompts para maximizar el prefijo que se puede almacenar en caché no está haciendo solamente una optimización de latencia: también está reduciendo la factura, y ahora tiene la cifra para demostrarlo.
Costo y rendimiento en la misma pantalla
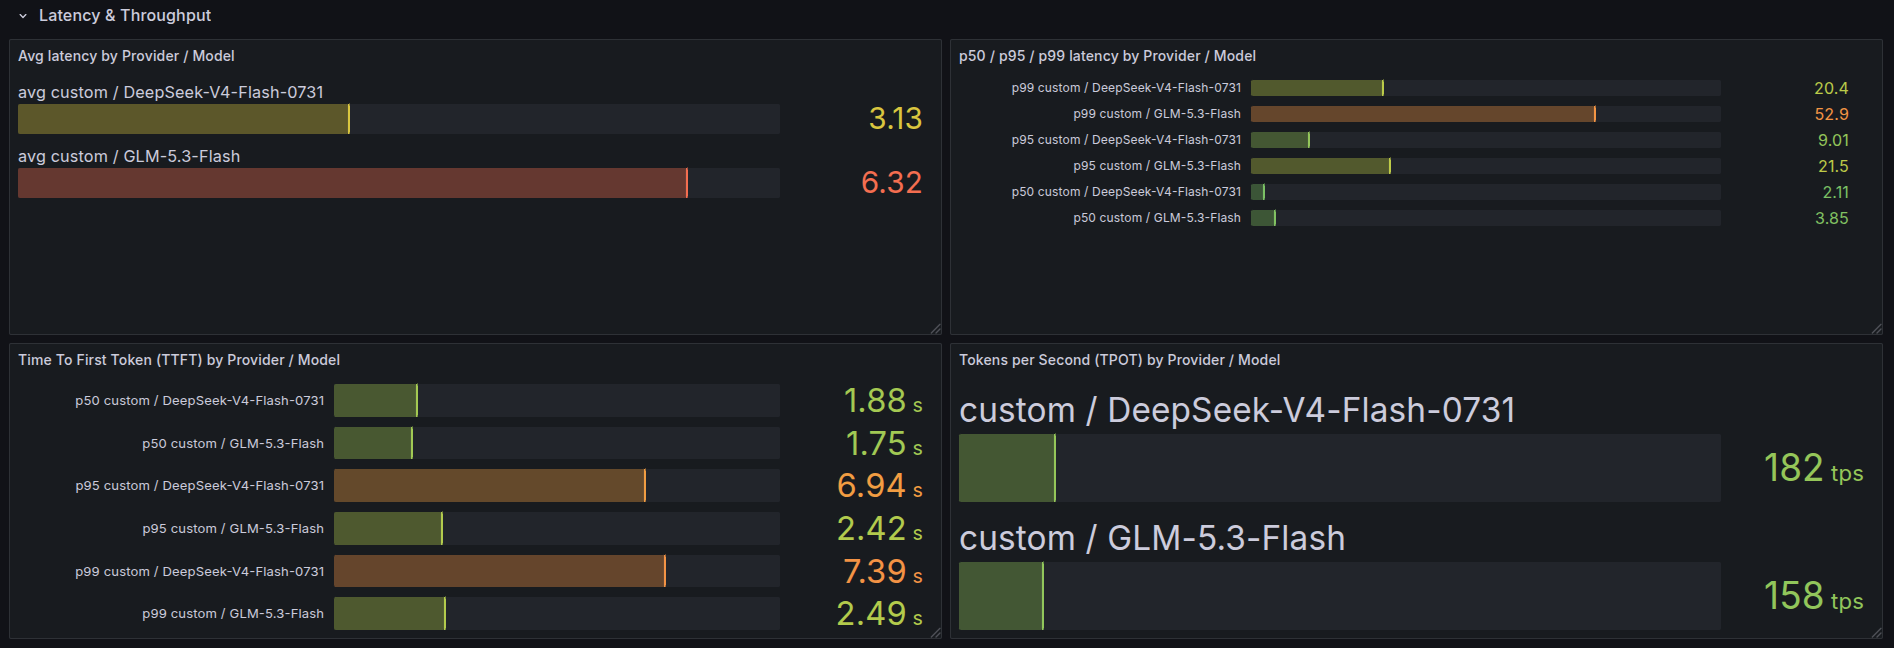
Los paneles de costos conviven con métricas como TTFT (Time to First Token), tokens por segundo y percentiles de latencia. No solo por conveniencia de diseño, sino porque toda decisión de costos en IA implica un compromiso con la calidad o la latencia. Cambiar un modelo por uno más barato es una decisión de dos variables. Ver ambas en el mismo lugar es lo que permite tomarla con datos en lugar de opiniones.
A continuación, puedes consultar algunas de las métricas observadas con Sensedia AI Gateway:
Capa 3 de AI FinOps: Atribución
La identidad es el contrato
La diferencia entre showback y chargeback no es solamente el reporte, sino también la dimensión de atribución. El showback muestra que tu plataforma de IA gastó 40 mil dólares. El chargeback dice que 12 mil corresponden al equipo de atención al cliente, 10 mil al equipo de ventas y 18 mil a marketing, y carga esos montos al presupuesto de cada uno. Para lograrlo, necesitas un atributo estable, presente en cada solicitud, que indique de qué área provino esa llamada.
Claims del JWT
Sensedia AI Gateway utiliza claims del JWT como dimensiones de distribución de costos. El cliente puede incluir en el token JWT el área, el proyecto o el equipo, y el Gateway divide las métricas de costos de acuerdo con ese claim configurado. Esta fue una decisión de arquitectura, y conviene dejar más claro cuál es la alternativa que descarta.
El camino más común en el mercado es el uso de una virtual key: una clave de API por equipo, emitida por el Gateway, con la distribución de costos derivada de la clave que se utilizó. Es sencillo al inicio y termina en una proliferación de claves de API: un registro paralelo de claves que hay que mantener sincronizado con el IdP de la empresa y que queda desactualizado con la primera reorganización, fusión de squads o persona que cambia de área. La granularidad de la distribución de costos queda limitada por tu disciplina en la gestión de claves.
Al vincular la atribución al token que tu IdP ya emite, la distribución de costos sigue automáticamente el organigrama. El área correcta llega en cada solicitud porque, de forma natural, ya está ahí, y no porque alguien recordó actualizar una hoja de cálculo de claves.
Como todo en arquitectura implica compromisos, esta elección obviamente exige más configuración inicial y conlleva una responsabilidad compartida, porque corresponde al cliente de Sensedia garantizar que los claims correctos estén en el token y configurados en la plataforma. A cambio, exige mucho menos mantenimiento a largo plazo, y el dato de distribución de costos hereda la gobernanza de identidad que la empresa ya tiene.
Capa 4 de AI FinOps: Gobernanza
¿Por qué el rate limit no protege el presupuesto?
Todo API Gateway tradicional sabe limitar solicitudes por minuto. Es una de las políticas más antiguas de la categoría, pero no sirve para el presupuesto de IA, y el motivo es aritmético. Mil solicitudes pueden costar 2 o 2,000 dólares, dependiendo del modelo elegido, del tamaño del contexto enviado y de cuántos tokens generó la respuesta. Un límite basado solamente en solicitudes no es un límite presupuestario, es un límite de tráfico (que incluso puede comportarse como un presupuesto mientras el patrón de uso no cambie). Sin embargo, sabemos que el patrón de uso de IA cambia cada semana.
Por lo tanto, solo un límite basado en costos es realmente un límite presupuestario. Sensedia AI Gateway permite definir topes de costo por ruta con un rate limit medido en dólares, y no solamente en llamadas. Al alcanzar el tope definido, entra en vigor la acción de enforcement configurada.
¿Por qué en el AI Gateway y no en el sistema de facturación?
La pregunta es válida: ¿el área de finanzas no controla ya el presupuesto? Al cierre, sí. El sistema de facturación sabe que se excedió después de que ocurrió. El Gateway lo sabe en el momento de la respuesta de cada solicitud, porque es el que calcula el costo (capa 1) con el precio que realmente pagas (capa 2). La gobernanza de costos de IA debe ocurrir en el recorrido de la solicitud; de lo contrario, se convierte solamente en contabilidad.
Hoja de ruta de adopción
Si estás empezando, el orden de las capas que presentamos es el punto de partida:
- Centraliza tu tráfico de IA en un Gateway: sin una capa central de gobernanza de IA, nada de lo demás existe. El consumo directo del proveedor de LLM es un punto ciego que cargas para siempre.
- Activa la medición y utiliza el precio predeterminado durante algunas semanas: tener la cifra aproximada hoy vale más que tener la cifra exacta dentro de un trimestre.
- Registra tus tarifas negociadas: aquí es donde la cifra deja de ser solamente una métrica y se convierte en una base defendible para la distribución de costos.
- Publica el showback antes de cobrarle a alguien: dales a los equipos un tiempo para visualizar su propio consumo. La conversación sobre chargeback se vuelve mucho más fácil cuando nadie es tomado por sorpresa.
- Activa budgets en las rutas críticas: empieza monitoreando el consumo y después aplica bloqueos, una vez que los equipos ya conozcan sus propios patrones de consumo.
Una nota sobre conciliación
Conviene anticipar una objeción de cualquier profesional experimentado de FinOps: el costo registrado por el AI Gateway no va a coincidir exactamente con la factura del proveedor. No coincidirá, y ninguna herramienta logra hacerlo. Los escenarios causados por reintentos, streamings abortados, diferencias de redondeo y periodos de cierre distintos siempre pueden generar alguna discrepancia.
El objetivo del costo monitoreado en el Gateway no es sustituir la factura, sino ayudar a explicarla. La factura dice cuánto, y el Gateway dice a quién corresponde, en qué modelo, en qué aplicación y por qué. Una discrepancia de una fracción porcentual entre ambos es ruido. Una cifra agregada sin ninguna atribución es un problema de gestión mucho mayor.
La elección final tiene que ver con la fricción
Los tres escenarios siguientes cambian el comportamiento de los equipos de distintas formas:
- El showback cambia el comportamiento mediante la transparencia: nadie quiere aparecer en la parte superior de la lista de mayores consumidores (al menos no sin un motivo defendible).
- El chargeback cambia el comportamiento mediante el presupuesto: el costo de IA pasa a competir con las demás prioridades financieras del equipo.
- El budget cambia el comportamiento mediante el bloqueo: es una capa de protección, no la estrategia.
Elige el grado de fricción que tu organización puede soportar. Pero observa que los tres van a exigir exactamente la misma base técnica que discutimos: costo real, calculado en el recorrido de la solicitud, con el precio que efectivamente pagas, atribuido a una identidad que no queda desactualizada.
Esa es la base que ofrece Sensedia, lo que permite que tu organización construya su propia estrategia sobre nuestra plataforma. El resto es política interna, y esa es una decisión tuya.
¿Quieres saber cómo habilitar la disciplina de FinOps en tu negocio? ¡Habla ahora con nuestros especialistas!

Inicie su transformación con nosotros
Sensedia está especializada en soluciones de arquitectura basada en eventos, con experiencia desde la creación de estrategias hasta su implementación.
Contenido relacionado
La combinación perfecta de experiencia, personal y plataforma para gestionar sus API.
Su arquitectura digital es más integrada, ágil y escalable.
Acelere la entrega de sus iniciativas digitales a través de APIs, Microservicios e Integraciones menos complejas y más eficientes que impulsen su negocio.